Pourquoi les Materialized Lake Views ?
Les data engineers passent souvent trop de temps à orchestrer des pipelines au lieu de transformer les données. Les nouvelles Materialized Lake Views (MLV) de Microsoft Fabric changent la donne. Elles vous permettent de déclarer les transformations en SQL, et Fabric prend automatiquement en charge la persistance, la planification du refresh, la lineage, le monitoring et même la validation de la qualité des données.
Microsoft décrit les MLV comme des pipelines déclaratifs pour votre Lakehouse : vous dites ce que vous voulez, et Fabric gère le comment.
Contrairement aux pipelines traditionnels où vous devez construire vous-même l'orchestration, la gestion des erreurs et les contrôles de qualité, les MLV intègrent ces aspects by design. Avec de simples contraintes SQL, vous pouvez imposer des règles de qualité des données (supprimer les enregistrements non valides ou arrêter le pipeline en cas de violation), et Fabric génère automatiquement des rapports et des insights de lineage pour les surveiller.
Nous avons exploré cette fonctionnalité en détail et l'avons comparée à notre Fabric Ignite Framework, qui utilise dbt pour les transformations.
Les deux approches visent à fournir des données fiables et prêtes pour l'analytique, mais elles diffèrent en termes d'effort de configuration, de flexibilité et de modèle de gouvernance.
Ce blog offre un aperçu général des MLV et de leur comparaison avec dbt.
Pour ceux qui souhaitent suivre en détail notre configuration étape par étape et nos scénarios de test techniques, nous avons mis à disposition la documentation technique complète 
Comment fonctionnent les MLV ?
- Définies en SQL dans des notebooks ou l'UI (le support de PySpark est prévu).
- Les résultats sont stockés sous forme de Delta tables dans OneLake, optimisés pour Power BI Direct Lake.
- Suivi automatique de la lineage et orchestration des dataflows : aucune configuration manuelle de pipeline nécessaire.
- Contrôles de qualité des données intégrés via des contraintes :
ON MISMATCH FAIL : arrête l'exécution du pipeline.
ON MISMATCH DROP : ignore les lignes non valides mais poursuit l'exécution du pipeline.
Exemple : du Bronze au Gold
À l'aide du dataset AdventureWorks, nous avons implémenté une architecture Medallion classique avec des
MLV
· Bronze : CSV bruts (ventes, adresses, cartes de crédit, personnes).
· Silver : vues nettoyées et enrichies, par ex.
addresses ajoute les noms State et Country.
creditcards joint le nom du titulaire depuis la table person.
· Gold : orderheaders agrégés, combinant les données de ventes avec les adresses enrichies et les infos de carte de crédit.

Surveillance de la qualité des données
· La vue lineage dans Fabric montre les dépendances entre les MLV et génère un pipeline exécutable.
· Les refreshes sont intelligents : si aucune donnée source n'a changé, l'exécution est ignorée. (Actuellement full refresh uniquement ; le refresh incrémental est sur la roadmap.)
· Monitoring intégré via :
table sys_dq_metrics : enregistrements supprimés, violations par contrainte.
Data Quality Reports générés automatiquement : vue d'ensemble et détail par MLV.

Avantages des MLV
Les MLV sont entièrement créées, soit dans l'UI de Fabric, soit sous forme de requête SQL dans un Notebook. Fabric gère tout le traitement backend pour vous (logique de refresh, gestion du pipeline basée sur les dépendances entre les MLV et leurs sources, gestion des violations de règles de qualité des données, scheduling, monitoring et reporting).
Les analystes et les professionnels de la donnée n'ont qu'à définir ce qu'ils veulent dans une requête SQL (transformations, agrégations, règles et actions de qualité des données, etc.), sans avoir besoin d'infrastructure supplémentaire et/ou de compétences d'ingénierie.
Elles s'intègrent parfaitement dans l'écosystème de Microsoft Fabric sans nécessiter de développement manuel et/ou de configuration complexe.
Les MLV sont matérialisées, ce qui signifie que leur contenu est physiquement stocké et peut être interrogé beaucoup plus rapidement que des vues standard. Une logique de refresh efficace (seules les MLV dont les données source ont changé sont rafraîchies) réduit le temps de traitement et le coût des ressources cloud. (Remarque : prend actuellement en charge le full refresh ou l'absence de refresh ; le chargement incrémental est prévu dans de futures mises à jour.)
Limites actuelles
Il s'agit d'une première version des MLV ; plusieurs fonctionnalités sont encore sur la roadmap pour de futures releases (comme le support de la syntaxe déclarative pour PySpark (où seul le SQL peut être utilisé actuellement), les capacités d'incremental refresh, le support d'API pour la gestion des MLV, les fonctionnalités de lineage et d'exécution cross-lakehouse, etc.). Certaines restrictions s'appliquent à l'utilisation de fonctions et à la recherche de motifs avec des opérateurs tels que LIKE ou regex dans les conditions de contrainte.
Une lineage de Materialized Lake Views consécutives est requise pour garantir que le DataFlow/pipeline est généré correctement ; les autres types de transformations ne seront pas pris en compte. Les tables sources doivent également être chargées via un autre type de transformation (et via leur propre pipeline) ; leur chargement ne fait pas partie du DataFlow/schedule des MLV. Il n'existe qu'un seul DataFlow/schedule de MLV, incluant toutes les MLV, même si elles ne sont pas liées entre elles. Il n'existe aucune possibilité de scinder le DataFlow/schedule des MLV en, par exemple, des Subject Areas.
Des contrôles de qualité des données en échec entraînent l'une des actions suivantes : soit supprimer les enregistrements dont le contrôle de qualité échoue, soit arrêter l'exécution de la MLV et des MLV suivantes. Ces 2 types d'actions sont toutefois surveillés différemment (les MLV Runs dans la lineage n'afficheront que l'exécution en échec des MLV due à des erreurs DQ, tandis que la table sys_dq_metrics n'affichera que le nombre d'enregistrements supprimés lors d'une exécution de MLV), ce qui rend le suivi plus difficile.
Ni framework de test, ni intégration Git ne sont actuellement disponibles.
Perspectives
Les Materialized Lake Views sont encore jeunes, mais Microsoft les fait évoluer rapidement. L'incremental refresh et le support de PySpark sont déjà sur la roadmap. Une intégration plus poussée avec Purview, Git et les API fait actuellement défaut.
Aujourd'hui, les MLV sont déjà un excellent choix pour la livraison rapide de datasets curatés dans Fabric, surtout en combinaison avec Power BI Direct Lake.
À l'avenir, nous nous attendons à ce que les MLV deviennent encore plus puissantes avec des capacités telles que :
- Un traitement incrémental plus intelligent
- Une qualité des données et des tests intégrés plus riches
- Une collaboration complète basée sur Git et un support CI/CD
- Une lineage cross-lakehouse pour le data mesh d'entreprise
- Des optimisations de performance avec refresh adaptatif et caching
Ces innovations élèveront les MLV d'un facilitateur low-code à une solution d'entreprise stratégique pour l'analytics engineering avancé.
Fabric Ignite Framework avec dbt versus Fabric Materialized Lake Views
Dans notre Fabric Ignite framework, nous nous appuyons sur dbt pour gérer les transformations. dbt nous offre des tests avancés, des workflows basés sur Git et des capacités matures d'incremental refresh : des fonctionnalités que les data engineers adorent pour construire des pipelines complexes et gouvernés.
Avec l'arrivée des Materialized Lake Views (MLV) dans Fabric, nous voyons désormais une alternative convaincante pour certains scénarios. Les MLV brillent lorsque vous voulez une livraison rapide de datasets curatés, une configuration minimale et une gouvernance native à Fabric, tandis que dbt reste plus fort pour les modèles incrémentaux, les tests avancés et les bonnes pratiques CI/CD.
En pratique, de nombreuses organisations combineront probablement les deux approches : utiliser les MLV pour les workloads low-code et natifs à Fabric, tout en tirant parti de dbt là où la complexité d'ingénierie, la portabilité et les pratiques DevOps sont essentielles.
Comparaison entre MLV et dbt :
Fonctionnalité / besoin | Materialized Lake Views (MLV) | dbt |
Temps de configuration | Quelques minutes, entièrement dans l'UI de Fabric | Nécessite la configuration de dbt Core/Cloud, un repo Git, des configs |
Incremental refresh |
|
|
Intégration de la gouvernance |
| Partiel : nécessite une intégration supplémentaire |
Gestion des dépendances |
|
|
Framework de test |
|
|
Contrôle de version |
|
|
Cross-platform |
|
|
Courbe d'apprentissage | Faible (axé SQL) | Plus élevée (YAML, Jinja, CLI, Git) |
Idéal pour | Transformations simples à moyennes dans le Lakehouse, entièrement gérées par Fabric | Transformations complexes et ingénierées, CI/CD, multi-plateforme |
 (full refresh uniquement, incrémental prévu)
 Modèles incrémentaux natifs
Cas d'usage
Un cas d'usage a été mis en place selon l'architecture medallion en organisant les données en trois couches :
- bronze (données brutes)
- silver (données nettoyées et enrichies)
- gold (données agrégées et analysées).
Certaines tables du schéma OLTP AdventureWorks 2008 (une base de données exemple pour Microsoft SQL Server) seront utilisées comme source pour ce cas d'usage. Ces tables ont été téléchargées sous forme de fichiers CSV et chargées en tant que Delta Table dans une Bronze couche Bronze de Fabric :
Table | Description | Delta Table dans la couche Bronze de Fabric |
Sales.SalesOrderHeader | Informations générales sur les commandes de vente. | adventureworks_bronze.salesorderheader |
Person.Address | Informations d'adresse postale pour les clients, employés et fournisseurs. | adventureworks_bronze.address |
Person.StateProvince | Table de recherche des états et provinces. | adventureworks_bronze.stateprovince |
Person.CountryRegion | Table de recherche contenant les codes ISO standard des pays et régions. | adventureworks_bronze.countryregion |
Sales.CreditCard | Informations de carte de crédit des clients. | adventureworks_bronze.creditcard |
Sales.PersonCreditCard | Table de correspondance reliant les personnes à leurs informations de carte de crédit dans la table CreditCard. | adventureworks_bronze.personcreditcard |
Person.Person | Personnes impliquées avec AdventureWorks : employés, contacts clients et contacts fournisseurs. | adventureworks_bronze.person |
Le DataModel de la couche Bronze :

Remarque : les relations de tables ci-dessus ont été ajoutées au DataModel après la création des MLV (voir étapes suivantes) afin de rendre le DataModel plus visuel. Elles ne sont pas nécessaires et/ou utilisées par Fabric pour configurer les MLV.
Dans la Silver couche Silver, 2 tables enrichies/nettoyées seront mises en place. Elles sont créées en tant que Materialized Lake Views :
- addresses Toutes les adresses de la table source address seront enrichies avec le StateProvince Name et le CountryRegion Name récupérés dans les tables sources appropriées.
- creditcards – Toutes les cartes de crédit de la table source creditcard seront enrichies avec le nom du titulaire de la carte, dérivé de la table source persons.
Afin de démontrer les capacités de qualité des données intégrées des MLV, certaines contraintes sont définies :
- addresses Toutes les adresses doivent avoir un StateProvince Name et un CountryRegion Name. S'ils ne peuvent pas être dérivés des tables sources appropriées, la MLV ne doit pas être mise à jour et le pipeline doit s'arrêter en échec.
- creditcards Toutes les cartes de crédit doivent avoir un Number, un Expiry Month et un Expiry Year. S'ils ne peuvent pas être dérivés de la table source appropriée, ces cartes de crédit ne doivent pas être incluses dans la MLV, mais l'exécution du pipeline peut continuer.
Scripts de création des MLV dans la couche Silver de Fabric :
Remarque : les attributs utilisés par les contraintes doivent être définis dans l'instruction SELECT. Dans l'exemple ci-dessus, Bill To AddressId et Ship To AddressId ne sont ajoutés que pour être utilisés par la contrainte, ils n'ont aucune business value. Toutefois, faire référence à bta.AddressID ou sta.AddressID dans les contraintes entraînera une erreur).
Une fois les MLV créées, une Data Lineage View est générée automatiquement. Pour accéder à cette vue, naviguez vers le Lakehouse et sélectionnez Managed Materialized Lake View :

Les MLV elles-mêmes sont également stockées sous forme de Delta Tables et se retrouvent en tant que telles dans la section Tables du Lakehouse.

Cette lineage générée automatiquement peut être planifiée comme un pipeline.
Notez cependant :
- Seules les MLV sont rafraîchies. Le rafraîchissement des données dans les Delta Tables de la couche Bronze doit dans l'exemple ci-dessus se faire d'une autre manière et ne peut pas être intégré dans le pipeline généré automatiquement. Il en va de même si, par exemple, d'autres tables de données dans l'une des couches doivent être manipulées.
- Toutes les MLV, même si elles n'appartiennent pas à la même data lineage, font partie de la même Data Lineage View/pipeline. La partie supérieure de la data lineage présentée ci-dessous est celle du cas d'usage utilisé dans ce blog, la partie inférieure est un autre cas d'usage. Les deux ne partagent aucun objet.
 Sélectionnez Schedule dans le ruban de navigation afin de créer et/ou maintenir le scheduling du pipeline MLV :
 Le menu déroulant en haut à gauche liste les exécutions actuelles et historiques, et doit être utilisé pour surveiller/dépanner les exécutions du pipeline.

Cliquer sur une activité dans la partie lineage de l'écran ou sur la liste d'activités en bas de l'écran affichera plus de détails sur l'exécution/les erreurs/etc.
Remarques :
- Toutes les MLV sont dans le même pipeline (voir remarque précédente). Toutes les MLV sans dépendance d'entrée d'une autre MLV sont démarrées simultanément, et à partir de ce point, les dépendances déterminent le chemin à suivre.
- Aucune trace des enregistrements supprimés en raison des contraintes de qualité des données ne peut être trouvée sur les activités ; elles seront considérées comme terminées, sans aucun avertissement ni indication.
Scénarios
Pour le cas d'usage, un certain nombre de scénarios seront mis en place afin de démontrer les différentes fonctionnalités des MLV.
Les données fournies par Microsoft pour le schéma OLTP AdventureWorks 2008 ne contiennent aucun écart par rapport aux règles de qualité des données spécifiées :
- Tous les enregistrements OrderHeader ont un Bill To AddressId et un Ship To AddressId.
- Toutes les adresses peuvent être liées à un StateProvince Name et un CountryRegion Name.
- Toutes les cartes de crédit peuvent être liées à une personne.
Contrôles de qualité des données initiaux :
Scenario 1
Il s'agit de l'Initial Load, sans écart dans la qualité des données (voir ci-dessus).
Le schedule des MLV s'exécute avec succès :

La table sys_dq_metrics peut être utilisée pour surveiller le nombre d'enregistrements chargés. Elle fait référence à des métriques de qualité des données au niveau système, utilisées pour mesurer et surveiller la qualité des données dans une base de données ou un pipeline de données. Ces métriques aident à garantir que les données sont exactes, complètes, cohérentes et fiables pour la prise de décision.
Dans cette table, les enregistrements suivants se réfèrent au Scénario 1 :
Le Total Rows Processed pour chaque MLV correspond au nombre d'enregistrements dans leurs driving tables (salesorderheader, address et creditcard dans la couche Bronze).
Aucune ligne n'a été supprimée, aucune violation n'a été trouvée.
Scenario 2
Sans rien changer au contenu de la couche Bronze, le schedule des MLV est redémarré
Le schedule des MLV s'exécute avec succès :
Dans la table sys_dq_metrics, les enregistrements suivants se réfèrent au Scénario 2 :
Le Total Rows Processed pour chaque MLV est 0. Aucune ligne n'a été supprimée, aucune violation n'a été trouvée.
Le système détecte qu'aucune modification n'a été apportée aux données source utilisées par les MLV. La RefreshPolicy estNoRefresh, et le Message estAucune mise à jour de données dans la table source dont dépend la MLV, et donc aucun refresh n'a été effectué’.
Cela prouve que seules les parties de la lineage qui ont changé seront rafraîchies. Notez toutefois qu'aucun chargement incrémental n'est actuellement pris en charge ; soit un full refresh de la MLV se produit, soit aucun refresh.
Scenario 3
Nous allons forcer un problème de qualité des données en mettant à jour un CountryRegionCode dans la table countryregion de la couche Bronze. Cela entraînera un CountryRegion vide dans la MLV addresses de la couche Silver, violant la contrainte countryregion_chk dans cette MLV.
L'instruction SQL Data Manipulation Language (DML) suivante est exécutée pour forcer le problème de qualité des données :
- Le schedule des MLV ne s'exécute pas avec succès :

- La MLV creditcards s'exécute avec succès ;
- La MLV addresses échoue en raison de la violation de la contrainte countryregion_chk dans cette MLV, alors que le paramètre ON MISMATCH de cette contrainte est réglé sur FAIL. L'error log affiche :
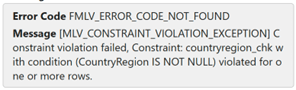
- Le pipeline s'arrête en raison de la violation de qualité des données ; la MLV orderheaders ne s'exécutera pas
La table sys_dq_metrics ne contient aucun enregistrement pour les MLV qui ont échoué ou n'ont pas été exécutées, donc la seule entrée pour le Scénario 3 est :

Remarque :
Les contraintes en échec semblent chronophages. Pendant mes tests, la MLV addresses en échec a pris plus de 5 minutes :

alors que le chargement initial (Scénario 1, chargement de 19 614 adresses) n'a pris que 43 secondes. Des tests antérieurs avec la même MLV ont montré des résultats similaires (> 5 minutes en cas de violations de contrainte) :

Scenario 4
Nous allons résoudre à nouveau le problème de qualité des données CountryRegionCode et forcer un autre problème de qualité des données en mettant à jour l'Expiration Month dans la table creditcard de la couche Bronze (tous les Expiration Months = 1 seront changés en null). Cela entraînera un ExpMonth vide dans la MLV creditcards de la couche Silver, violant la contrainte expirationmonth_chk dans cette MLV.
Les instructions SQL Data Manipulation Language (DML) suivantes sont exécutées pour forcer le problème de qualité des données :
Le schedule des MLV s'exécute avec succès :

La MLV creditcards n'échoue pas malgré la violation de la contrainte expirationmonth_chk dans cette MLV, car le paramètre ON MISMATCH de cette contrainte est réglé sur DROP. Le seul endroit où vous pouvez voir les enregistrements supprimés est la table sys_dq_metrics. Elle contient le nombre de violations / d'enregistrements supprimés et le nombre d'enregistrements par contrainte en échec pour le Scénario 4 :
- Le nombre d'enregistrements dans la MLV creditcards de la couche Silver = 17 505 (soit 19 118 enregistrements dans la table source creditcard de la couche Bronze moins 1 613 cartes de crédit en échec (en raison d'un Expiration Month manquant)).
- La MLV orderheaders ne manque aucun enregistrement ; le code SQL de cette MLV contient un Left Outer Join vers la MLV creditcard, et aucune contrainte de qualité des données liée aux cartes de crédit n'a été définie dans la MLV orderheaders ;
- Contrairement aux contraintes avec un paramètre ON MISMATCH FAIL, les MLV avec un paramètre ON MISMATCH DROP ne prennent apparemment que peu ou pas de temps supplémentaire
MLV Data Quality Reports
Sur le ruban de la page materialized lake views, un bouton Data quality report est disponible.
En appuyant sur ce bouton, un data quality report généré automatiquement s'ouvre, contenant à la fois une page de vue d'ensemble et une page de détail :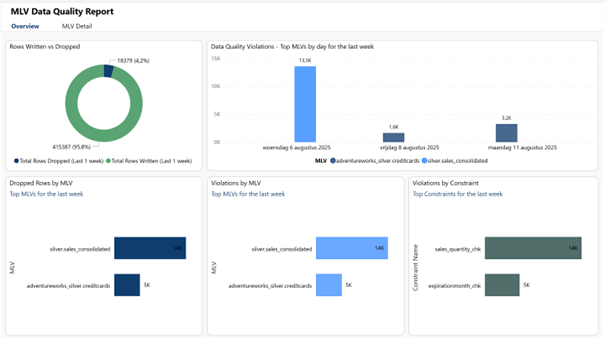

Alors que la page de vue d'ensemble résume toutes les données de toutes les MLV, la page de détail vous permet de vous concentrer sur une ou plusieurs MLV.
Remarque :
Ces rapports ne tiennent PAS compte des exécutions de MLV en échec dues au paramètre ON MISMATCH réglé sur FAIL sur une contrainte de MLV ; ils se concentrent uniquement sur les paramètres ON MISMATCH réglés sur DROP. Cela signifie que ni les Data Quality Reports, ni la table sys_dq_metrics ne montreront l'impact des problèmes de qualité des données bloquants !!!