Waarom Materialized Lake Views?
Data engineers besteden vaak te veel tijd aan het orchestreren van pijplijnen in plaats van aan het transformeren van data. De nieuwe Materialized Lake Views (MLV's) van Microsoft Fabric veranderen dat. Ze laten je transformaties in SQL declareren, en Fabric zorgt automatisch voor persistentie, refresh-scheduling, lineage, monitoring en zelfs datakwaliteitsvalidatie.
Microsoft beschrijft MLV's als declaratieve pijplijnen voor je Lakehouse: jij zegt wat je wilt, en Fabric regelt het hoe.
In tegenstelling tot traditionele pijplijnen waar je zelf orchestratie, error handling en kwaliteitscontroles moet bouwen, integreren MLV's deze aspecten by design. Met eenvoudige SQL-constraints kun je datakwaliteitsregels afdwingen (ongeldige records droppen of de pijplijn stoppen bij overtredingen), en Fabric genereert automatisch rapporten en lineage-inzichten om ze te monitoren.
We onderzochten deze functionaliteit in detail en vergeleken ze met ons Fabric Ignite Framework, dat dbt gebruikt voor transformaties.
Beide benaderingen willen betrouwbare, analytics-ready data leveren, maar ze verschillen in setupinspanning, flexibiliteit en governancemodel.
Deze blog geeft een overzicht op hoofdlijnen van MLV's en hun vergelijking met dbt.
Voor wie onze stapsgewijze setup en technische testscenario's in detail wil volgen, hebben we de volledige technische documentatie beschikbaar gemaakt 
Hoe werken MLV's?
- Gedefinieerd met SQL in notebooks of de UI (PySpark-ondersteuning is gepland).
- Resultaten worden opgeslagen als Delta-tabellen in OneLake, geoptimaliseerd voor Power BI Direct Lake.
- Automatische lineage-tracking en dataflow-orchestratie: geen manuele pijplijnsetup nodig.
- Ingebouwde datakwaliteitscontroles via constraints:
ON MISMATCH FAIL: stopt de uitvoering van de pijplijn.
ON MISMATCH DROP: slaat ongeldige rijen over maar zet de uitvoering van de pijplijn voort.
Voorbeeld: van Bronze naar Gold
Met de AdventureWorks-dataset implementeerden we een klassieke Medallion-architectuur met
MLV's
· Bronze: ruwe CSV's (sales, adressen, kredietkaarten, personen).
· Silver: opgeschoonde, verrijkte views, bv.
addresses voegt State- en Country-namen toe.
creditcards joint de naam van de houder uit de person-tabel.
· Gold: geaggregeerde orderheaders, die salesdata combineren met verrijkte adressen en kredietkaartinfo.

Datakwaliteit monitoren
· De lineage-view in Fabric toont de afhankelijkheden tussen MLV's en genereert een uitvoerbare pijplijn.
· Refreshes zijn slim: als er geen brondata is gewijzigd, wordt de run overgeslagen. (Momenteel alleen full refresh; incremental refresh staat op de roadmap.)
· Ingebouwde monitoring via:
sys_dq_metrics-tabel: gedropte records, overtredingen per constraint.
Automatisch gegenereerde Data Quality Reports: overzicht en detail per MLV.

Voordelen van MLV's
MLV's worden volledig aangemaakt, ofwel in de UI van Fabric, ofwel als een SQL-query in een Notebook. Fabric verzorgt alle backend-verwerking voor jou (refresh-logica, pijplijnbeheer op basis van afhankelijkheden tussen MLV's en hun bronnen, afhandeling van overtredingen van datakwaliteitsregels, scheduling, monitoring en rapportering).
Analisten en dataprofessionals hoeven alleen in een SQL-query te definiëren wat ze willen (transformaties, aggregaties, datakwaliteitsregels en -acties, enz.), zonder dat ze extra infrastructuur en/of engineeringvaardigheden nodig hebben.
Ze passen volledig in het ecosysteem van Microsoft Fabric zonder manueel ontwikkelwerk en/of een complexe setup te vereisen.
MLV's zijn gematerialiseerd, wat betekent dat hun inhoud fysiek is opgeslagen en veel sneller kan worden bevraagd dan standaard views. Een efficiënte refresh-logica (alleen MLV's met wijzigingen in de brondata worden vernieuwd) verlaagt de verwerkingstijd en de kosten van cloudresources. (Opmerking: ondersteunt momenteel full refresh of geen refresh; incrementeel laden is gepland in toekomstige updates.)
Beperkingen vandaag
Dit is een eerste versie van MLV's; verschillende features staan nog op de roadmap voor toekomstige releases (zoals ondersteuning voor declaratieve syntax voor PySpark (waar momenteel alleen SQL kan worden gebruikt), incremental refresh-mogelijkheden, API-ondersteuning voor het beheren van MLV's, cross-lakehouse lineage- en uitvoeringsfeatures, enz.). Er gelden enkele beperkingen op het gebruik van functies en patroonzoekopdrachten met operators zoals LIKE of regex in constraint-condities.
Een lineage van opeenvolgende Materialized Lake Views is vereist om er zeker van te zijn dat de DataFlow/pijplijn correct wordt gegenereerd; andere types transformaties worden niet in aanmerking genomen. Brontabellen moeten ook via een ander type transformatie worden geladen (en via een eigen pijplijn); het laden ervan maakt geen deel uit van de MLV-DataFlow/schedule. Er bestaat slechts één MLV-DataFlow/schedule, inclusief alle MLV's, zelfs als ze niet aan elkaar gerelateerd zijn. Er bestaat geen mogelijkheid om de MLV-DataFlow/schedule op te splitsen in bijvoorbeeld Subject Areas.
Falende datakwaliteitscontroles resulteren in een van de volgende acties: ofwel de records met een falende datakwaliteitscontrole droppen, ofwel de uitvoering van de MLV en de daaropvolgende MLV's stoppen. Deze 2 types acties worden echter verschillend gemonitord (de MLV-runs in de lineage tonen alleen de falende uitvoering van de MLV's door DQ-fouten, terwijl de sys_dq_metrics-tabel alleen het aantal gedropte records tijdens een MLV-uitvoering toont), wat het moeilijker maakt om dit op te volgen.
Er is momenteel noch een testframework, noch Git-integratie beschikbaar.
Vooruitblik
Materialized Lake Views zijn nog jong, maar Microsoft ontwikkelt ze snel verder. Incremental refresh en PySpark-ondersteuning staan al op de roadmap. Diepere integratie met Purview, Git en API's ontbreekt momenteel.
Vandaag zijn MLV's al een uitstekende keuze voor de snelle levering van gecureerde datasets in Fabric, zeker in combinatie met Power BI Direct Lake.
Vooruitkijkend verwachten we dat MLV's nog krachtiger worden met mogelijkheden zoals:
- Slimmere incrementele verwerking
- Rijkere ingebouwde datakwaliteit en testing
- Volledige Git-gebaseerde samenwerking en CI/CD-ondersteuning
- Cross-lakehouse lineage voor enterprise data mesh
- Performanceoptimalisaties met adaptieve refresh en caching
Deze innovaties zullen MLV's tillen van een low-code-enabler naar een strategische enterprise-oplossing voor geavanceerde analytics engineering.
Fabric Ignite Framework met dbt versus Fabric Materialized Lake Views
In ons Fabric Ignite framework, vertrouwen we op dbt voor het beheren van transformaties. dbt geeft ons geavanceerde testing, Git-gebaseerde workflows en volwassen incremental refresh-mogelijkheden: features waar data engineers van houden bij het bouwen van complexe, gegovernde pijplijnen.
Met de komst van Materialized Lake Views (MLV's) in Fabric zien we nu een aantrekkelijk alternatief voor bepaalde scenario's. MLV's blinken uit wanneer je snelle levering van gecureerde datasets, minimale setup en Fabric-native governance wilt, terwijl dbt sterker blijft voor incrementele modellen, geavanceerde testing en CI/CD-best practices.
In de praktijk zullen veel organisaties waarschijnlijk beide benaderingen combineren: MLV's gebruiken voor low-code, Fabric-native workloads, en dbt inzetten waar engineeringcomplexiteit, portabiliteit en DevOps-praktijken essentieel zijn.
Vergelijking tussen MLV en dbt:
Feature / behoefte | Materialized Lake Views (MLV) | dbt |
Setuptijd | Minuten, volledig in de Fabric-UI | Vereist setup van dbt Core/Cloud, Git-repo, configs |
Incremental refresh |
|
|
Governance-integratie |
| Gedeeltelijk: vereist extra integratie |
Afhankelijkheidsbeheer |
|
|
Testframework |
|
|
Versiebeheer |
|
|
Cross-platform |
|
|
Leercurve | Laag (SQL-gericht) | Hoger (YAML, Jinja, CLI, Git) |
Best geschikt voor | Eenvoudige tot gemiddelde transformaties in Lakehouse, volledig door Fabric beheerd | Complexe, geëngineerde transformaties, CI/CD, multi-platform |
 (alleen full refresh, incrementeel gepland)
 Native incrementele modellen
Use case
Er werd een use case opgezet volgens de medallion-architectuur door data in drie lagen te organiseren:
- bronze (ruwe data)
- silver (opgeschoonde en verrijkte data)
- gold (geaggregeerde en geanalyseerde data).
Enkele tabellen uit het AdventureWorks 2008 OLTP-schema (een voorbeelddatabase voor Microsoft SQL Server) worden gebruikt als bron voor deze use case. Deze tabellen werden gedownload als CSV-bestanden en geladen als Delta Table in een Bronze -laag van Fabric:
Tabel | Beschrijving | Delta Table in Bronze-laag Fabric |
Sales.SalesOrderHeader | Algemene informatie over verkooporders. | adventureworks_bronze.salesorderheader |
Person.Address | Straatadresinformatie voor klanten, werknemers en leveranciers. | adventureworks_bronze.address |
Person.StateProvince | Opzoektabel voor staten en provincies. | adventureworks_bronze.stateprovince |
Person.CountryRegion | Opzoektabel met de ISO-standaardcodes voor landen en regio's. | adventureworks_bronze.countryregion |
Sales.CreditCard | Kredietkaartinformatie van klanten. | adventureworks_bronze.creditcard |
Sales.PersonCreditCard | Kruisverwijzingstabel die personen koppelt aan hun kredietkaartinformatie in de CreditCard-tabel. | adventureworks_bronze.personcreditcard |
Person.Person | Personen die betrokken zijn bij AdventureWorks: werknemers, klantcontacten en leverancierscontacten. | adventureworks_bronze.person |
Het datamodel van de Bronze-laag:

Opmerking: de bovenstaande tabelrelaties werden aan het datamodel toegevoegd nadat de MLV's (zie volgende stappen) waren aangemaakt, om het datamodel visueler te maken. Ze zijn niet noodzakelijk en/of worden niet door Fabric gebruikt om de MLV's op te zetten.
In de Silver -laag worden 2 verrijkte/opgeschoonde tabellen opgezet. Ze worden aangemaakt als Materialized Lake Views:
- addresses Alle adressen in de brontabel address worden verrijkt met de StateProvince Name en CountryRegion Name die uit de juiste brontabellen worden opgehaald.
- creditcards – Alle kredietkaarten in de brontabel creditcard worden verrijkt met de naam van de kredietkaarthouder, afgeleid uit de brontabel persons.
Om de ingebouwde datakwaliteitsmogelijkheden van MLV's te demonstreren, worden enkele constraints gedefinieerd:
- addresses Alle adressen moeten een StateProvince Name en CountryRegion Name hebben. Als die niet uit de juiste brontabellen kunnen worden afgeleid, mag de MLV niet worden bijgewerkt en moet de pijplijn met een fout stoppen.
- creditcards Alle kredietkaarten moeten een Number, Expiry Month en Expiry Year hebben. Als die niet uit de juiste brontabel kunnen worden afgeleid, mogen deze kredietkaarten niet in de MLV worden opgenomen, maar kan de uitvoering van de pijplijn doorgaan.
Aanmaakscripts voor de MLV's in de Silver-laag in Fabric:
Opmerking: de attributen die door constraints worden gebruikt, moeten in de SELECT-statement worden gedefinieerd. In het bovenstaande voorbeeld worden zowel Bill To AddressId als Ship To AddressId alleen toegevoegd voor gebruik door de constraint; ze hebben geen business value. Verwijzen naar bta.AddressID of sta.AddressID in de constraints leidt echter tot een fout).
Zodra de MLV's zijn aangemaakt, wordt automatisch een Data Lineage View gegenereerd. Om deze view te openen, navigeer je naar het Lakehouse en selecteer je Managed Materialized Lake View:

MLV's zelf worden ook opgeslagen als Delta Tables en zijn als zodanig terug te vinden in de Tables-sectie van het Lakehouse.

Deze automatisch gegenereerde lineage kan als een pijplijn worden ingepland.
Let echter op:
- Alleen MLV's worden vernieuwd. Het vernieuwen van data in de Delta Tables in de Bronze-laag moet in het bovenstaande voorbeeld op een andere manier gebeuren en kan niet in de automatisch gegenereerde pijplijn worden geïntegreerd. Hetzelfde geldt als bijvoorbeeld andere datatabellen in een van de lagen moeten worden gemanipuleerd.
- Alle MLV's, zelfs als ze niet tot dezelfde data lineage behoren, maken deel uit van dezelfde Data Lineage View/pijplijn. Het bovenste deel van de hieronder getoonde data lineage is dat van de use case uit deze blog, het onderste deel is een andere use case. Beide delen geen enkel object met elkaar.
 Selecteer Schedule in het navigatielint om de scheduling van de MLV-pijplijn aan te maken en/of te onderhouden:
 Het dropdownmenu linksboven toont de huidige en historische runs en moet worden gebruikt om de uitvoeringen van de pijplijn te monitoren/troubleshooten.

Klikken op een activiteit in het lineage-gedeelte van het scherm of op de activiteitenlijst onderaan het scherm toont meer details over uitvoering/fouten/enz.
Opmerkingen:
- Alle MLV's zitten in dezelfde pijplijn (zie eerdere opmerking). Alle MLV's zonder inputafhankelijkheid van een andere MLV worden gelijktijdig gestart, en vanaf dat punt bepalen de afhankelijkheden het te volgen pad.
- Er is geen spoor van gedropte records door datakwaliteitsconstraints terug te vinden op de activiteiten; ze worden beschouwd als voltooid, zonder enige waarschuwing of indicatie.
Scenario's
Voor de use case worden een aantal scenario's opgezet om de verschillende functionaliteiten van de MLV's te demonstreren.
De data die door Microsoft voor het AdventureWorks 2008 OLTP-schema worden aangeleverd, bevatten geen enkele afwijking van de gespecificeerde datakwaliteitsregels:
- Alle OrderHeader-records hebben een Bill To AddressId en een Ship To AddressId.
- Alle adressen kunnen worden gekoppeld aan een StateProvince Name en een CountryRegion Name.
- Alle kredietkaarten kunnen worden gekoppeld aan een persoon.
Initiële datakwaliteitscontroles:
Scenario 1
Dit is de Initial Load, zonder afwijkingen in de datakwaliteit (zie boven).
De MLV-schedule draait succesvol:

De sys_dq_metrics-tabel kan worden gebruikt om het aantal geladen records te monitoren. Ze verwijst naar datakwaliteitsmetrics op systeemniveau, die worden gebruikt om de kwaliteit van data in een database of datapijplijn te meten en te monitoren. Deze metrics helpen ervoor te zorgen dat data accuraat, volledig, consistent en betrouwbaar is voor de besluitvorming.
In deze tabel verwijzen de volgende records naar Scenario 1:
De Total Rows Processed voor elke MLV komt overeen met het aantal records in hun driving tables (salesorderheader, address en creditcard in de Bronze-laag).
Er werden geen rijen gedropt, er werden geen overtredingen gevonden.
Scenario 2
Zonder iets aan de inhoud van de Bronze-laag te wijzigen, wordt de MLV-schedule opnieuw gestart
De MLV-schedule draait succesvol:
In de sys_dq_metrics-tabel verwijzen de volgende records naar Scenario 2:
De Total Rows Processed voor elke MLV is 0. Er werden geen rijen gedropt, er werden geen overtredingen gevonden.
Het systeem detecteert dat er geen wijzigingen zijn aangebracht aan de brondata die door de MLV's wordt gebruikt. De RefreshPolicy isNoRefresh, en het bericht isGeen data-update in de brontabel waarvan de MLV afhangt, en dus werd er geen refresh uitgevoerd’.
Dit bewijst dat alleen de delen van de lineage die zijn gewijzigd, worden vernieuwd. Merk echter op dat er momenteel geen incrementele loads worden ondersteund; ofwel gebeurt er een full refresh van de MLV, ofwel geen refresh.
Scenario 3
We forceren een datakwaliteitsprobleem door een CountryRegionCode in de countryregion-tabel in de Bronze-laag bij te werken. Dit resulteert in een lege CountryRegion in de addresses-MLV in de Silver-laag, wat de constraint countryregion_chk in die MLV overtreedt.
De volgende Data Manipulation Language (DML) SQL-statement wordt uitgevoerd om het datakwaliteitsprobleem te forceren:
- De MLV-schedule draait niet succesvol:

- De creditcards-MLV draait succesvol;
- De addresses-MLV faalt door de overtreding van de constraint countryregion_chk in die MLV, terwijl de ON MISMATCH-parameter voor deze constraint op FAIL staat. De error log toont:
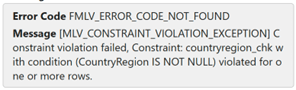
- De pijplijn stopt door de datakwaliteitsovertreding; de orderheaders-MLV draait niet
De sys_dq_metrics-tabel bevat geen records voor MLV's die faalden of niet draaiden, dus de enige entry voor Scenario 3 is:

Opmerking:
Falende constraints lijken tijdrovend te zijn. Tijdens mijn tests duurde de falende MLV addresses meer dan 5 minuten:

terwijl de initiële load (Scenario 1, 19.614 adressen laden) slechts 43 seconden duurde. Eerdere tests met dezelfde MLV toonden vergelijkbare resultaten (> 5 minuten bij constraintovertredingen):

Scenario 4
We lossen het CountryRegionCode-datakwaliteitsprobleem opnieuw op en forceren een ander datakwaliteitsprobleem door de Expiration Month in de creditcard-tabel in de Bronze-laag bij te werken (alle Expiration Months = 1 worden gewijzigd naar null). Dit resulteert in een lege ExpMonth in de creditcards-MLV in de Silver-laag, wat de constraint expirationmonth_chk in die MLV overtreedt.
De volgende Data Manipulation Language (DML) SQL-statements worden uitgevoerd om het datakwaliteitsprobleem te forceren:
De MLV-schedule draait succesvol:

De creditcards-MLV faalt niet door de overtreding van de constraint expirationmonth_chk in die MLV, terwijl de ON MISMATCH-parameter voor deze constraint op DROP staat. De enige plek waar je de gedropte records kunt zien, is de sys_dq_metrics-tabel. Ze bevat het aantal overtredingen / gedropte records en het aantal records per falende constraint voor Scenario 4:
- Het aantal records in de MLV creditcards in de Silver-laag = 17.505 (namelijk 19.118 records in de brontabel creditcard van de Bronze-laag min 1.613 falende kredietkaarten (door een ontbrekende Expiration Month)).
- De orderheaders-MLV mist geen enkele record; de SQL-code voor deze MLV bevat een Left Outer Join naar de creditcard-MLV, en er werden geen datakwaliteitsconstraints gedefinieerd in de orderheaders-MLV met betrekking tot kredietkaarten;
- In tegenstelling tot de constraints met een ON MISMATCH-parameter FAIL, nemen de MLV's met een ON MISMATCH-parameter DROP blijkbaar weinig tot geen extra tijd in beslag
MLV Data Quality Reports
Op het lint van de materialized lake views-pagina is een Data quality report -knop te vinden.
Door op deze knop te drukken, wordt een automatisch gegenereerd data quality report geopend, met zowel een overzichtspagina als een detailpagina: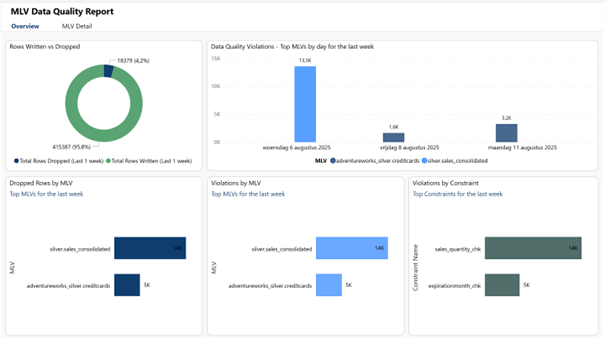

Terwijl de overzichtspagina alle data van alle MLV's samenvat, laat de detailpagina je focussen op één of meer MLV's.
Opmerking:
Deze rapporten houden GEEN rekening met de falende MLV-uitvoeringen door de ON MISMATCH-parameter op een MLV-constraint die op FAIL staat; ze focussen alleen op ON MISMATCH-parameters die op DROP staan. Dit betekent dat noch de Data Quality Reports, noch de sys_dq_metrics-tabel de impact van blokkerende datakwaliteitsproblemen zullen tonen!!!