Elke goede Solutions- of Data Architect heeft op elk moment wel verschillende issues op zijn tafel liggen. Dat is normaal. Wat abnormaal is, is dat hetzelfde probleem telkens weer op die tafel belandt. Dat is het ene herhaalbare patroon dat je wilt kwijtraken. Data-automatisering draait er ten eerste om deze patronen te vinden en ten tweede erop te acteren.
De oplossing conceptueel op de juiste plek oplossen zou altijd de status quo van de architect moeten zijn. Hoewel dit altijd wenselijk is, doet tijdsdruk ons soms domme dingen doen. Maar wanneer je oplossingen op herhaalbare patronen zijn gebouwd, dwingt dat je enigszins de juiste kant op.
Het is heel oncomfortabel om point solutions te fixen als ze door een geautomatiseerd proces zijn gegenereerd. Je maakt een paar vijanden door zulke gesiloede oplossingen te creëren.
Door herhaalbare patronen te gebruiken, word je gedwongen om uit te zoomen en het probleem end-to-end te bekijken. Zo word je bijvoorbeeld gedwongen om naar het logische datamodel te kijken en mogelijke tekortkomingen te identificeren, in plaats van simpelweg wat SQL-code aan te passen die data in je doelobject laadt. Het maakt duidelijk dat je patroon niet perfect is en dwingt je zo om het robuuster te maken.
Je kunt je altijd uit een lastige situatie coderen, maar het is niet duurzaam om overal in je ecosysteem maatwerk-codeerpatronen te hebben.
Ik ben geen grote voorstander van no-code platformen. Ik heb geen probleem met high-code platformen, zolang ik de code niet zelf hoef te schrijven of, als ik dat wel doe, maar één keer. Maar ik zou ernstig beperkt zijn als ik niet naar de code mag kijken en het patroon indien nodig mag bijstellen.
Wat data-automatisering betreft, zou het hypocriet van me zijn om deze afbeelding niet elke keer te delen wanneer ik erover praat. Dit blijft waar en men mag eraan herinnerd worden.
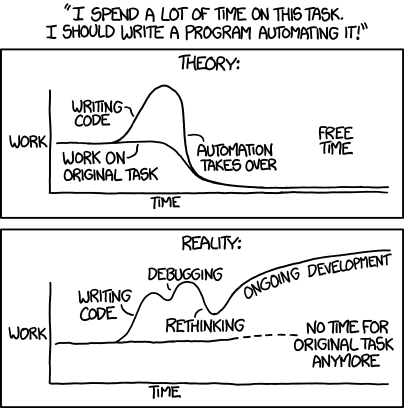
beeldcredit: xkcd.com
Alleen omdat iets pijnlijk is, betekent niet dat het niet de juiste keuze is. Die eerste templates en patronen opzetten is moeilijk, maar het zal op een bepaald moment het manuele werk overtreffen.
Hier zijn enkele van mijn voor de hand liggende herhaalbare patronen die je voor data-automatisering zou moeten overwegen.
Laden
Ongeacht je laadpatroon, of het nu batch loads, een CDC-aanpak of message-driven streaming is. De manier waarop je data op je gewenste platform of storage ingest, moet transform-light en herhaalbaar zijn. Het proces voor het laden opzetten zou een paar clicks moeten zijn.
Ik ben een voorstander van ELT: je data laden zoals ze is en transformeren in de target. Dat maakt het makkelijker om het laden te modulariseren, waarna het targetplatform het zware werk kan doen door query plans te optimaliseren voor de transformaties op de target.
Datatransformatie
De T in ETL/ELT hoeft niet puur maatwerk te zijn.
Verschillende functies modulariseren is een goed principe in veel beroepen, zeker in softwareontwikkeling. Modulariseer de functies die vaak worden herhaald. Enkele voorbeelden hiervan zijn data cleansing-patronen en harde business rules zoals data type casting.
Conceptueel (daar is dat woord weer) doe je dezelfde dingen op dezelfde plek. Cleanse en transformeer niet in 1 stap. Zo kun je de repetitieve taken modulariseren en ze scheiden van de niet-repetitieve.
De T is ook stijlafhankelijk. Een Data Vault-modelleerstijl is bijvoorbeeld sterk gericht op automatisering en dus een no-brainer om een sterke focus op herhaalbare patronen te hebben, maar zelfs 3NF- en Kimball-modelleerstijlen zijn erg repetitief van aard.
Kies een modelleerstijl en hou je eraan. Dit kan uiteraard een combinatie van design patterns zijn, maar beslis over een standaard en voorkom individuele puntvariaties. Je houden aan de patronen die je voor jezelf hebt uitgetekend, dwingt je ook om het juiste op de juiste plek te doen. Door geen specifieke modelleertechniek te kiezen, maak je ook een keuze: je laat de beslissingen over aan elke engineer. Dat resulteert in spaghetti-code die niet herhaalbaar is. Introduceer gerust nieuwe patronen als de nood zich voordoet, maar introduceer ze als een patroon in plaats van data engineers vrij spel te geven.
Data Quality
Modulariseer en herhaal kwaliteitscontroles in je data-acquisitieproces, maar zorg ervoor dat ze in de juiste handen belanden.
Gefaalde kwaliteitscontroles moeten terugvloeien naar de mensen die worden afgerekend op slechte data. Of dat nu je product owners of aangestelde data stewards zijn, ze moeten proactief zijn om data quality-problemen weg te werken.
Een eenvoudige processflow zou er zo kunnen uitzien, waarbij de "slechte data" verborgen wordt. Data kan verborgen worden door datasets te taggen als ze kwaliteitscontroles hebben gefaald. Ze kunnen dan worden uitgesloten in laadprocessen of verborgen via views of row/column-level security.
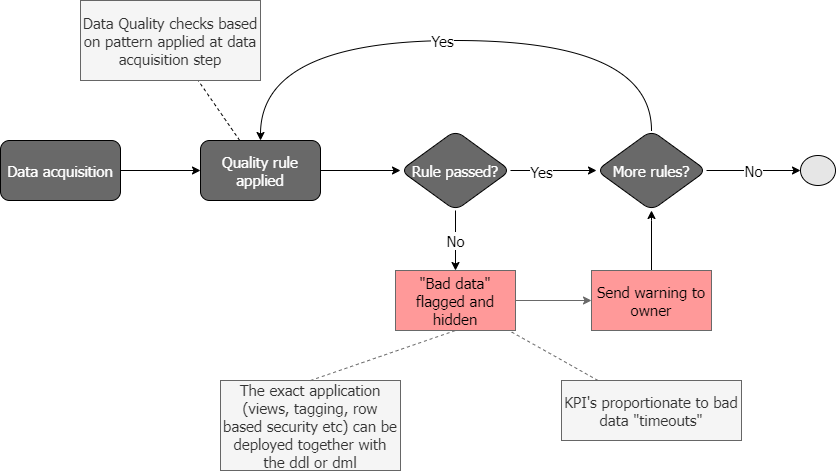
Hoe je ook beslist om de gefaalde data te taggen, verbergen of uit te sluiten, ze kan als DDL-statements worden meegeleverd, ingebouwd in je automatiseringsproces.
Distributiestrategie
De distributie van data op MPP-platformen is een cruciaal onderdeel in de levenscyclus en duurzaamheid van je dataplatformen.
Afhankelijk van je modelleerpatronen kan dit sterk of licht geautomatiseerd zijn, maar er zouden geen automatiseringskansen mogen zijn die je onbenut laat.
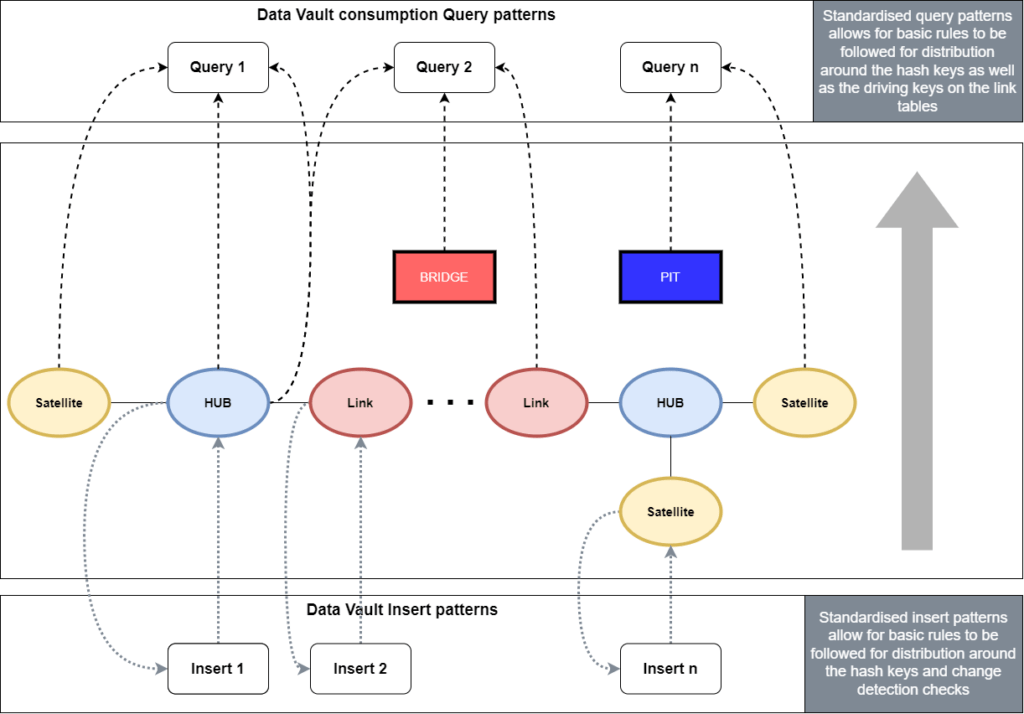
Ongeacht je platform is de manier waarop je data zou moeten opslaan gebaseerd op verschillende factoren, zoals query patterns, de hoeveelheid data en of de objecten geoptimaliseerd moeten zijn voor lezen of schrijven. Query patterns hangen sterk af van de datamodelleerstijl die je gebruikt. Veel van deze factoren zijn bekend op designtijd en dus kan de distributie worden toegewezen bij de initiële creatie van DDL. Sommige vragen verfijning na verloop van tijd, naarmate je datagroottes en query patterns veranderen. Dit kan nog steeds geautomatiseerd worden, omdat het continu health checks op je data uitvoert.
Door de repetitieve en gestandaardiseerde aard van Data Vault als modelleerstijl is er een goede kans om correcte distributiestandaarden toe te passen zonder tussenkomst. Op designtijd kan dit worden overschreven mocht het wijzigingen vereisen.
Doorgaans hebben verschillende platformen (zoals Synapse, Redshift, Snowflake en Delta Lake, om er een paar te noemen) goede documentatie beschikbaar over welke strategieën te volgen inzake partitioning, distributie en clustering. Meestal hebben ze ook documentatie om je te vertellen hoe je health checks uitvoert om te zien of je data skew is geworden. Je kunt dan de learnings van deze grotere community meenemen en ze inbakken in een herhaalbaar patroon dat je periodiek laat draaien, zodat je data kan "self-healen".
Data Security
Data security krijgt heel wat aandacht telkens ik met klanten praat. Het is altijd belangrijk geweest, maar het wordt genuanceerder. De meeste bedrijven verhuizen naar de cloud en "as a service"-oplossingen. Dit, samen met de complexiteit rond persoonsgegevens, maakt het een ingewikkelde taak om te bevatten. Niet alleen heeft elk land zijn eigen wetgeving, elk bedrijf heeft zijn eigen interpretatie van die wetgeving.
Disclaimer: automatisering lost die nuances niet op.
Automatisering laat je wel veel sneller itereren en je security policies testen. Geef het compliance-team iets om mee te werken. Alleen advocaten kunnen werken met regels op papier, de rest van ons moet het in actie zien.
Je zou security policies niet handmatig op basis van gebruiker of rol hoeven toe te passen. Definieer policies vooraf en idealiter wil je dat die deploybaar (niet deplorabel) zijn op designtijd.
Afhankelijk van je datamodelleerstijl kun je gevoelige data makkelijk naar verschillende genormaliseerde tabellen in beveiligde schema's deployen (zoals bij Data Vault), of je kunt ze samenhouden maar column- of row-level policies op de tabel toepassen via de DDL-generatie. Of je de data nu maskeert, versleutelt of gewoon afschermt van de gebruiker, de meeste targetplatformen voorzien sommige of al deze features. Het design blijft homogeen, de deployment stem je af op basis van naar welk targetplatform je deployt.
Testen
Hier is al veel over geschreven, en ik zou je aanraden om onder andere te lezen over testing in data ops¹.
Dit is een breed onderwerp en ik benadruk gewoon één aspect dat volgens mij verwaarloosd wordt: curated input, curated output. Gecureerde datasets creëren waartegen je kunt testen, dat is waar de pijn en de glorie liggen.
Meeting invites afwijzen
Oké, dit is een bonus, maar mensen zijn helemaal "Zoomed out". Goed gearchitecteerde oplossingen gaan hand in hand met goed uitgevoerde plannen. Beide hebben van tijd tot tijd wat ononderbroken, gefocuste inspanning nodig.
Kortom, als je data-automatisering end-to-end bekijkt, zijn er waarschijnlijk nog veel meer domeinen en functies die je kunt automatiseren, maar ik vind dat deze zes een cruciale rol spelen in de duurzaamheid van je architectuur. De patronen hiervoor continu verbeteren, dwingt je om goed gearchitecteerde oplossingen te bouwen en de cyclus te doorbreken waarin je telkens dezelfde issues moet fixen.
Blijf jezelf gewoon afvragen waar herhaalbare patronen bestaan of waar ze verbeterd kunnen worden · verbeter het patroon, spoel en herhaal.
OVER DE AUTEURS
Corné Potgieter
Data Architect